412名新秀,都是第一次存在
先看其中三个人。边锋季沅,19岁,身高171厘米,左脚,出身沿海小城的街头足球,青年联赛两年只踢了23场,却有41次成功过人。中卫庞彻,20岁,身高191厘米,在大学联赛当了三年队长,速度一般,但几乎不犯低级错误。前腰莫笙,18岁,身高176厘米,十四岁之前练的是田径中长跑,转项踢球只有四年,技术粗糙,跑动数据却是全届第一。
这三个人在第7赛季之前并不存在。他们没有原型,也不是从某个固定名单里随机抽出来的,而是由九游体育的新秀生成模型在赛季结束时一次性创造出来的。问题在于,“随机生成”四个字很容易做成灾难:属性乱配、位置失衡、同一届出现十几个几乎一样的前锋。要让412个人每一个都经得起玩家反复查看,生成过程必须有顺序,也必须有约束。
先有经历,再有球员
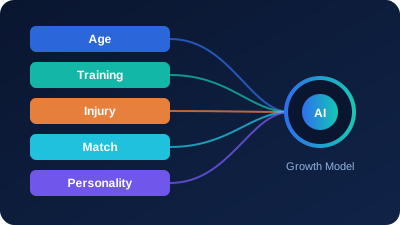
很多游戏生成球员的做法是先定位置,再按位置随机分配属性。九游体育反过来,先生成一段简短的过往经历:出生地区、开始踢球的年龄、青训出身、踢过的联赛级别、有没有转过项目、有没有经历过严重伤病、在队里扮演过什么角色。
经历会约束后面的一切。季沅的街头足球背景意味着他的盘带和一对一属性偏高,而战术纪律、无球防守偏低;十六岁才进入正规青训,意味着他接受系统训练的时间短,成长曲线更可能是大器晚成型。莫笙的田径背景直接解释了他的耐力和跑动,也解释了他的第一脚触球为什么只有52。庞彻当了三年队长,这会影响他的领导力和情绪稳定性。
这样做的好处是,玩家在球员档案里看到的每一个数字都有来路。当玩家问“为什么这个18岁的前腰跑动这么好却控球这么差”,答案就写在他的经历里,而不是一个随机种子。关于模型需要为一名球员记住哪些信息,可以延伸阅读体育成长大模型到底需要记住一名球员多少信息。
经历本身也会受到联盟历史的影响。模型会读取过去几个赛季这个虚构世界里发生的事:某个地区的俱乐部连续三年在青年联赛夺冠,那里的新秀在下一届就更可能拥有扎实的青训出身;某支球队的明星边锋拿下联赛最佳,几年后会出现更多以他为偶像、踢法相近的少年;某个大学联赛改了赛制,出场机会变多,来自那里的新秀比赛经验就会整体提高。这样一来,新秀不是凭空掉进联盟的,而是从这个世界的过去里长出来的。
性格:同样的能力,不同的人
经历生成之后,模型会给每名新秀生成一组性格维度,主要包括职业态度、好胜心、情绪稳定性、学习意愿、领导力和对出场时间的敏感度。性格同样受经历约束:长期担任队长的球员领导力偏高;在多支球队之间辗转的球员对出场时间更敏感;转项运动员的学习意愿往往高于平均。
性格不是装饰。它决定了这名新秀进入职业队后会怎么对待训练、怎么面对替补、受伤后能不能尽快回到状态。季沅的好胜心很高,情绪稳定性偏低,他可能在状态好的时候一场连过五人,也可能在连续被换下后和教练起冲突。两名能力完全相同的新秀,因为性格不同,五年后的样子可能相差十几点。
为了避免性格变成一张平均分表,模型在每一届里会刻意保留一定比例的“极端性格”:极度自律但缺乏自信的、天赋出众但职业态度很差的、平平无奇却极其稳定的。这些人往往是一届选秀里最有故事的部分。
身体与技术:属性之间必须互相约束
属性生成是最容易出问题的一步。九游体育的做法是把属性分成几个相互关联的簇,而不是让每个属性独立随机。
- 身体簇:身高、体重、速度、爆发力、力量、耐力。身高191厘米的庞彻可以有很好的力量和头球,但速度和灵活性会受到限制;身高171厘米的季沅,灵活性和加速上限更高,对抗上限较低。
- 技术簇:控球、传球、射门、盘带、弱侧脚。技术簇和训练年限、青训出身高度相关,街头足球背景会拉高盘带、压低传球的稳定性。
- 意识簇:站位、决策、无球跑动、视野。意识簇与比赛经验相关,踢过高级别联赛的新秀这一簇整体更成熟。
模型还要控制总量。一名新秀的当前能力不是各项属性随手相加,而是先根据年龄和经历确定一个合理的能力档位,再在各簇之间分配。这样可以避免出现某个18岁新秀所有属性都在80以上的情况。偶尔出现一个特别突出的人是允许的,但他一定会在某些地方付出代价,比如莫笙的跑动顶尖、技术粗糙。
位置分布和反克隆:让一届新秀像一个真实的群体
一届412名新秀,如果前锋有150个、门将只有4个,选秀就没法进行。模型会参考联盟各队的阵容结构和老化情况,给每个位置设定一个大致的目标比例,并允许在一定范围内波动。门将通常占7%到9%,中卫占14%到18%,边路和中场占比最大。
另一个约束是反克隆。模型在生成过程中会计算新秀之间的相似度,综合考虑位置、身体数据、属性分布、性格组合和经历类型。当两个人相似度过高时,后生成的那一个会被调整:换一个出身、改变惯用脚、调整成长曲线,或者把他的特长从射门换成无球跑动。目标不是让每个人都与众不同到怪异,而是保证玩家在翻看名单时,不会觉得“这个人我刚刚见过”。
同名同姓、同一所大学出了五名首发级中卫、所有左脚球员都出现在同一个位置,这些细节也在检查范围内。它们单独看不算错误,但集中出现就会破坏真实感。
隐藏字段:潜力和成长曲线要能被表现解释
最后一步,是写入玩家看不到的字段:精确潜力、成长曲线类型、伤病倾向、适应能力。这些字段不会显示在任何界面上,玩家只能通过球探报告、比赛数据和试训逐步推断。
但隐藏不等于随意。模型要求隐藏字段和公开表现之间存在可以被发现的联系。季沅被设定为大器晚成型,潜力84,那么他的青年联赛数据里就应该有一些迹象:比如最后一个赛季的过人成功率明显高于前一个赛季,训练记录里的技术成长速度偏快。莫笙的潜力79,但他的学习意愿很高,这会体现在试训时他对教练指令的执行速度上。庞彻潜力只有76,却有极低的伤病倾向和极高的稳定性,他的比赛数据会呈现出罕见的低波动。
如果隐藏字段和公开表现完全无关,球探再努力也只能是在猜随机数,选秀就会变成运气游戏。只有当两者之间存在带噪声的联系时,玩家的观察和判断才有意义。
每一届都要有自己的性格
单个新秀像真的,还不够。一届选秀作为一个整体,也需要有辨识度。九游体育在生成每一届新秀之前,会先确定这一届的“年份特征”,比如:
- 顶端天才数量:有的年份只有一两个明显的状元热门,有的年份前五顺位难分高下。
- 位置倾斜:某一年中卫扎堆,某一年缺少可靠的门将。
- 成长曲线偏向:某一年早熟型偏多,前两个赛季很亮眼,后劲不足;某一年大器晚成型偏多,选秀当年看不出什么,五年后回头看却是大年。
- 深度:有的年份第二轮还能捞到首发,有的年份第一轮末段就已经很难选。
第7赛季这一届,年份特征被设定为“顶端平淡、深度出色、晚熟偏多”。这意味着选秀当晚不会出现一个人人认可的状元,各队球探的排序会比往年更分散,而真正的答案可能要等到第10赛季以后才会显现。年份特征不会直接写进任何一名新秀的档案,它只调整生成时的分布参数,比如把大器晚成型的比例从常规的两成提高到三成,把潜力85以上的名额压到只有五六个。玩家感受到的,是这一届“看不太准”的整体气质。关于选秀大年和普通年份如何形成,可以参考AI能不能让每一代新秀形成自己的“黄金一代”。
预测和职业:生成的是起点,不是结局
模型在生成每名新秀时,会根据他的全部字段预估一条可能的职业轨迹:大约在哪个年龄达到巅峰,巅峰能力在什么区间,职业生涯可能持续多久。但这条轨迹只是一个概率分布的中心,不是剧本。
季沅的预估轨迹是“23到27岁进入巅峰,巅峰能力80到86”。如果他被一支重视青训、有耐心给边锋出场时间的球队选中,而教练又能处理他的情绪波动,他可能摸到86;如果他去了一支只想马上赢球的球队,第一年坐板凳,好胜心和情绪不稳叠加,他可能在22岁就被租借到低级别联赛,职业生涯停在75左右。
这是新秀生成真正要达成的效果:每名新秀出生时都带着一套完整、可解释的身体、技术、性格和经历,但他最终变成什么样,取决于玩家怎么选他、怎么练他、怎么用他。九游体育的体育成长大模型负责让412个人都像真的存在过,而他们的故事,要由玩家和时间一起写完。